MuISi andmetest soome-ugri esemekogu uurimisrakenduseni

Töövoog kirjeldab, kuidas muuta Eesti Rahva Muuseumi soome-ugri esemekogu muuseumide infosüsteemist MuIS pärinevad metaandmed struktureeritud ja uuritavaks andmestikuks ning luua nende põhjal interaktiivne veebirakendus. Eesmärk on võimaldada soome-ugri esemekogu rahvarühmade, materjalide, kogujate, kogumisaja ja geograafilise päritolu järgi uurida. Lähteandmed pärinevad MuISi RDF-ekspordist ning sisaldavad teavet museaalide kohta. Kuna muuseumiandmed on kujunenud pika aja jooksul ja erinevate kirjelduspraktikate käigus, ei ole need algkujul kohe võrreldavad ega analüüsiks ja visualiseerimiseks sobivad.


Töövoos teisendasin RDF-andmed tabelkujule, kontrollisin ja korrastasin metaandmeid ning täiendasin neid analüüsi ja visualiseerimise jaoks vajalike tunnustega. Oluline osa protsessist on automaatselt eraldatud andmete võrdlemine MuISi algkirjetega ning ajaloolise kohainfo seostamine tänapäevaste kohanimedega. Tulemuseks on omavahel seotud andmetabelid ja Streamliti uurimisrakendus.

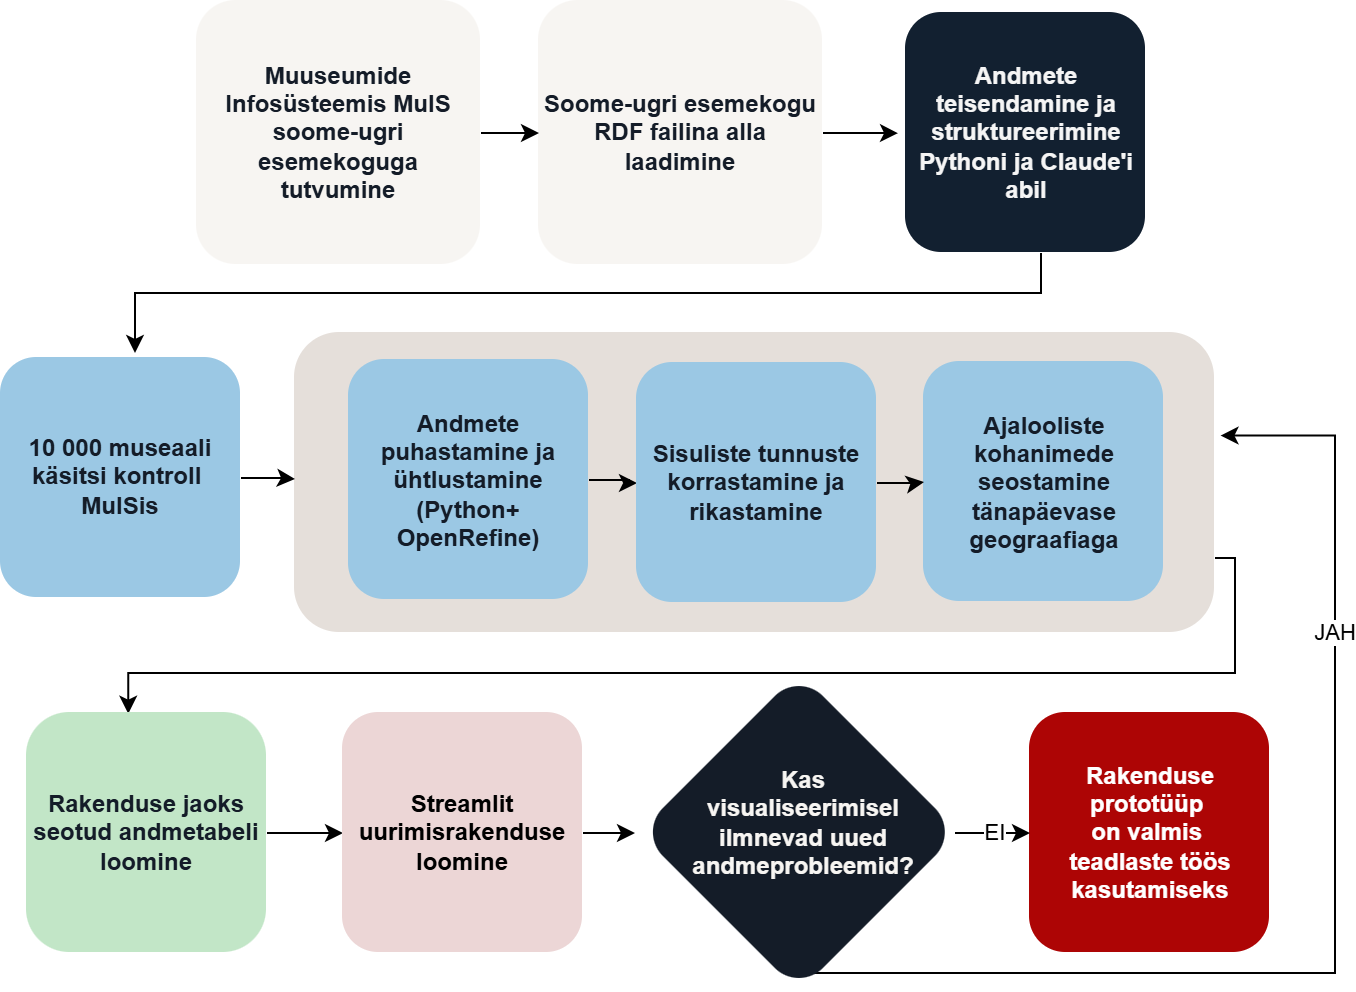
Töövoo sammud

Märksõnad: Avastamine, uurimine

Töövoo esimeses etapis tutvusin Eesti Rahva Muuseumi soome-ugri esemekogu metaandmetega, mis asuvad Muuseumide Infosüsteemis MuIS. Lähteandmed sain tehes veebilehel www.muis.ee otsing, millega kuvatakse kõik soome-ugri esemekogusse kuuluvad 10 000 museaali. Otsingutulemused salvestasin MuISi kasutajaliidese funktsiooniga “Salvesta tulemused RDF kujul”. Saadud RDF sisaldab omavahel seotud kirjete ja omadustena esemekogu museaalide viiteid ning on järgneva automaatse andmetöötluse lähtepunkt.

Selles etapis hindasin ka lähteandmete üldist struktuuri ja piiranguid. Tähelepanu pöörasin puuduvatele väärtustele, sama tüüpi info erinevatele kirjeldusviisidele ning sellele, kuidas museaalide kohta käiv informatsioon RDF-is paikneb. Eesmärk ei olnud veel andmeid parandada, vaid mõista, kuidas kogu on kirjeldatud ja milliseid andmeid on võimalik edasistes etappides struktureerida, võrrelda ja visualiseerida.

Märksõnad: Teisendamine, süntaksianalüüs, korraldamine

MuISist saadud RDF-faili töötlesin Pythonis. Esmalt eraldasin RDF-failist museaalide viited ning nende kaudu üksikute museaalide kirjed. RDF-i struktureeritud väljadest eraldasin programmiliselt näiteks museaali numbri, nimetuse, materjalid ja seotud sündmuste info. Museaalist kujunes andmestiku keskne üksus, mida identifitseerib unikaalne object_id ehk eri tabelites sama museaali siduv identifikaator.

Osa uurimiseks vajalikust infost paiknes MuISis vabatekstilistes kirjeldustes. Selle info esmaseks struktureerimiseks kasutasin tasulise Claude’i tehisintellekti API-t: museaali kommentaarivälja tekstist palusin eraldada kohanimed, rahvuse, kogumisaja ja kogujad ning lasin tagastada need struktureeritud kujul. Kogumisaegade ühtlustamiseks kasutasin lisaks Pythonis loodud reegleid, mis teisendasid eri kujul kirjutatud kuupäevad võimaluse korral standardsele kujule. Koodi arendamisel kasutasin abivahendina nii Claude’i kui ChatGPTd. Tehisintellekti abil info eraldamine on selles töövoos esmase struktureerimise katse, mitte usaldusväärseks peetav lõpptulemus ega töövoo kordamiseks kohustuslik samm.

Märksõnad: Andmete puhastamine, parandamine, täiendamine

Automaatse teisendamise järel hindasin saadud tabelite kvaliteeti. Selgus, et Pythonis Claude’i abil eraldatud info ei olnud piisavalt täielik ega usaldusväärne: osa väärtusi jäi leidmata, osa sattus valesse välja ning keerulisema struktuuriga MuISi kirjete puhul ei ole automaatselt eraldatud info alati üheselt tõlgendatav. Samuti olidki osal museaalidel osa välju tühjad. Seetõttu võrdlesin struktureeritud andmestikku algallikaga. Kontrollimiseks vaatasin MuISis ükshaaval üle ligi 10 000 kogusse kuuluvat museaali. Kontrolliks kulus umbes kaks kuud. Struktureeritud tabelites olevaid andmeid võrdlesin museaalide MuISi kirjetega ning parandasin ja täiendasin eelkõige kogujate, kohtade, kogumisaegade ja materjalidega seotud infot. See on töövoo oluline kvaliteedikontrolli etapp: automaatne andmetöötlus võimaldas suure andmestiku esmalt struktureerida, kuid algallika käsitsi kontroll osutus vajalikuks vigade ja puuduvate väärtuste tuvastamiseks

Märksõnad: Andmete puhastamine, parandamine, ühendamine

Pärast museaalide käsitsi kontrollimist hakkasin kontrollitud andmestikku süstemaatiliselt puhastama ja ühtlustama. Selleks kasutasin Pythonit ja OpenRefine’i. Korrastasin näiteks sama tähendusega väärtuste erinevaid kirjapilte, eemaldasin või parandasin selged vead, kontrollisin duplikaate ning ühtlustasin andmete vormingut. OpenRefine võimaldab sarnaseid tekstilis väärtusi rühmitada ja korraga parandada, Pythonit kasutasin suuremate tabelite töötlemiseks ning korduvate teisenduste automatiseerimiseks.

Selles etapis on oluline eristada tehnilist ühtlustamist sisulisest täiendamisest. Kui näiteks sama materjal, isik või koht esineb eri kirjapiltidega, saab need väärtused kontrollimise järel ühtlustada. Puuduvat või ebakindlat infot aga ei tuletund pelgalt teiste kirjete põhjal. Puhastamise tulemusena tekkisid järjepidevamad tabelid, mida sai järgmistes etappides edasi rikastada, omavahel siduda ja analüüsida.

Märksõnad: Annoteerimine, seostamine, täiendamine

Järgmises etapis korrastasin analüüsi jaoks olulisi sisulisi tunnuseid. Materjalide puhul seostasin väiksemad kategooriad laiemate materjalikategooriatega, säilitades samal ajal detailse materjaliväärtuse. Kontrollisin ka juhtumeid, kus materjalina kirjeldatud väärtus tähistas tegelikult pigem valmistamistehnikat, eseme detaili või muud omadust. Rahvusega seotud andmetes eristatasin üldisema rahvuse ning võimaluse korral täpsema rahvarühma, et algandmetes olevat detailsemat informatsiooni mitte üldistamise käigus kaotada.

Puuduvate või ebaselgete väärtuste kontrollimisel kasutasin vajaduse korral museaali kogumiskonteksti. Sama ekspeditsiooni või kogumisgrupi teised esemed võivad anda puuduva kirje mõistmiseks olulist lisainfot, kuid selliseid seoseid ei kasutanud automaatselt: võimalikud erandid kontrollisin eraldi. Samuti kasutasin ERMi varasemaid uurimistabeleid, kus oli lisadetaile just rahvusrühmade kohta, näiteks on erinevalt MuISist eristatud mäemari ja niidumari, permikomi ja sürjakomi esemed ja esemete päritolu. Etapi eesmärk oli muuta andmed omavahel paremini võrreldavaks, säilitades võimaluse korral ka vahe algallikast pärineva ja töö käigus lisatud või normaliseeritud informatsiooni vahel.

Märksõnad: Geoviitamine, ruumiandmete analüüs, kontekstualiseerimine, vastendus

Museaalide kogumiskohad on MuISis kirjeldatud eri ajastute haldusjaotuse ja erineva täpsusega: riigi, kubermangu, autonoomse vabariigi, oblasti, rajooni, valla või küla(nõukogu) tasemeni. Sama koht võib esineda mitmes keeles või eri kirjapildis. Seepärast eraldasin museaalide kohakirjeldustest kohanimed ja koondasin need võrreldavale kujule, eristades riigi, regiooni, rajooni ja võimaluse korral asula tasandit.

Tänapäevase haldusjaotuse võrdlusaluseks võtsin Venemaa ja Läti ametlike avaandmete keskkondades avaldatud haldusüksuste andmestikud. Koondasin museaalide algkirjeldustes esinevad regioonid ja rajoonid ning võrdlesin nende nimesid ja halduslikku kuuluvust võrdlusandmestikuga. Python võimaldas nimekujusid, korduvaid väärtusi ja tabelitevahelisi seoseid süsteemselt võrrelda. Sisulised vasted kontrollisin eraldi, eriti kui ajalooline haldusjaotus erines tänapäevasest, sama külanimi esines mitmes kohas või kirjeldus oli vastuoluline. Vajaduse korral kasutasin täiendavaid haldusallikaid ja vaatasin uuesti üle konkreetse museaali MuISi kirje. Alati ei olnudki konkreetset kohta välja toodud.

Vastandamisel eelistasin konkreetse museaali detailset kohakirjeldust ekspeditsiooni või kogu üldisele asukohale. Säiltasin algse kohanime ja kirjeldasin eraldi tänapäevase vaste ning selle täpsuse: riik, regioon, rajoon või asula. Kui tõendatud oli ainult regioon, ei lisanud ma rajooni ega küla oletuse põhjal. Tulemuseks kujunes kontrollitav kohanimede vastavustabel, mida sai museaalide andmetega siduda ja vajaduse korral hiljem täpsustada.

Märksõnad: Modelleerimine, andmete vastendus, ühendamine

Varasemates etappides loodud ja puhastatud tabelitest koostatasin rakenduse jaoks lõpliku andmemudel. Museaalide põhitabel sisaldab üht kirjet iga eseme kohta, korduvad tunnused, näiteks materjalid ja kogujad, paiknevad eraldi pikkades tabelites ning normaliseeritud geograafiline info sidusin museaalidega object_id kaudu. Selline ülesehitus võimaldas käsitleda korrektselt olukordi, kus ühe museaaliga on seotud mitu materjali või muud korduvat tunnust.

Andmemudeli loomisel kontrollisin, et eri tabelite ühendamine ei tekitaks museaalide kunstlikku paljunemist ega kaotaks kirjeid. Samuti valmistasin ette rakenduses kasutatavad tunnused, mille järgi saab kogu filtreerida, rühmitada ja visualiseerida. See etapp ühendas varasema andmete korrastamise rakenduse loomisega: puhastatud metaandmetest moodustasin struktuuri, mida interaktiivne uurimisvahend saab järjepidevalt kasutada.

Märksõnad: Veebiarendus, andmete visualiseerimine, vastendus

Puhastatud andmete põhjal lõin Streamliti veebirakenduse, mille kaudu saab Eesti Rahva Muuseumi soome-ugri esemekogu uurida ilma algseid andmetabeleid eraldi töötlemata. Rakendus võimaldab museaale filtreerida rahvuse ja rahvarühma, materjali ja materjalikategooria, koguja, kogumisaja ning geograafilise asukoha järgi. Kaardivaates saab uurida esemete jaotumist riikide ning Venemaa tänapäevaste regioonide ja rajoonide lõikes ning vaadata valitud piirkonnaga seotud museaale.

Rakenduse arendamiseks kasutasin Pythoni raamistikku Streamlit, mis võimaldab luua interaktiivseid veebirakendusi kasutajaliidest programmeerimata. Streamliti abil ühendasin ettevalmistatud andmetabelid filtrite, graafikute, museaalide ülevaadete ja kogujate võrgustikuvaadetega. Rakenduse lähtekood, kasutatavate andmetabelite struktuur ja käivitamisjuhised asuvad avalikus Githubi hoidlas.

Rakenduse veebiversioon on avaldatud Streamlit Community Cloudis, mis võimaldab seda kasutada programmi arvutisse tõmbata. Praegune uurimisrakendus on prototüüp, mille esmane sihtrühm on teadlased. Rakenduse eesmärk on võimaldada Eesti Rahva Muuseumi soome-ugri esemekogu süstemaatilist uurimist ning pakkuda võimalusi museaalide võrdlemiseks, filtreerimiseks ja nendevaheliste seoste analüüsimiseks.

Edasises arenduses on plaanis täiendada rakenduse funktsionaalsust, parandada alusandmete kvaliteeti ning muuta keskkond mitmekeelseks. Pikemas perspektiivis võiks rakendus olla kasutatav ka soome-ugri rahvaste kogukondadele endile, võimaldades neil tutvuda oma kultuuripärandiga ning uurida Eesti Rahva Muuseumi kogudes säilitatavaid esemeid.

Seega on rakenduse praegune eesmärk toetada teaduslikku uurimistööd, kuid selle edasine arendamine võiks suurendada ka kogude ligipääsetavust ja kasutusvõimalusi päritolukogukondade jaoks.

Rakenduse loomine toimib samal ajal ka andmekvaliteedi kontrollina. Filtrid, koondarvud, tabelid ja kaardid muudavad nähtavaks ebajärjekindlusi, mida üksikuid andmeridu vaadates on raske märgata: näiteks sama piirkonna erinevad nimekujud, ootamatult puuduvad kategooriad või valesti seostatud haldusüksused. Selliste probleemide avastamisel pöördun tagasi varasematesse puhastamise, rikastamise või geograafilise normaliseerimise etappidesse. Seetõttu on töövoog iteratiivne: visualiseerimine aitab andmeid kontrollida ning parandatud andmed omakorda parandavad visualiseeringut.